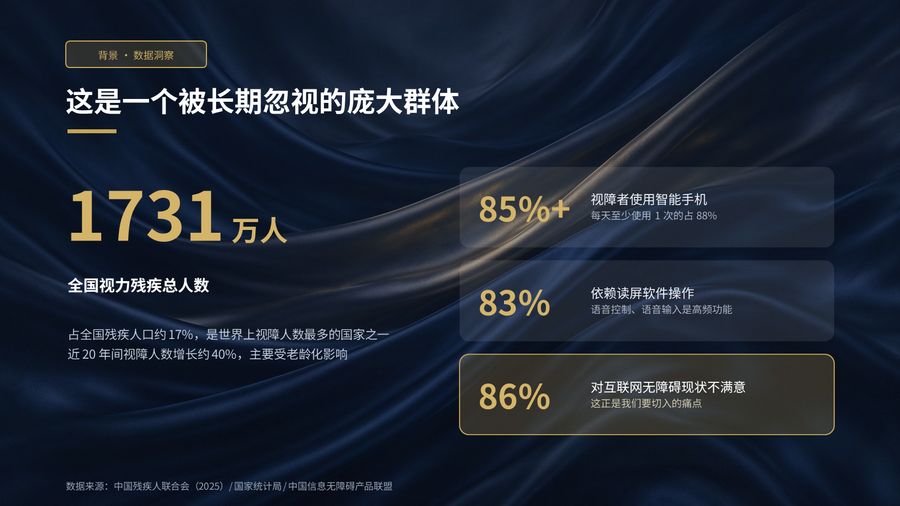
背景 · 数据洞察
这是一个被长期忽视的庞大群体
占全国残疾人口约 17%,是世界上视障人数最多的国家之一;近 20 年间视障人数增长约 40%,主要受老龄化影响。
85%+ 视障者使用智能手机
每天至少使用 1 次的占 88%
83% 依赖读屏软件操作
语音控制、语音输入是高频功能
86% 对互联网无障碍现状不满意
这正是我们要切入的痛点
数据来源:中国残疾人联合会(2025)/ 国家统计局 / 中国信息无障碍产品联盟
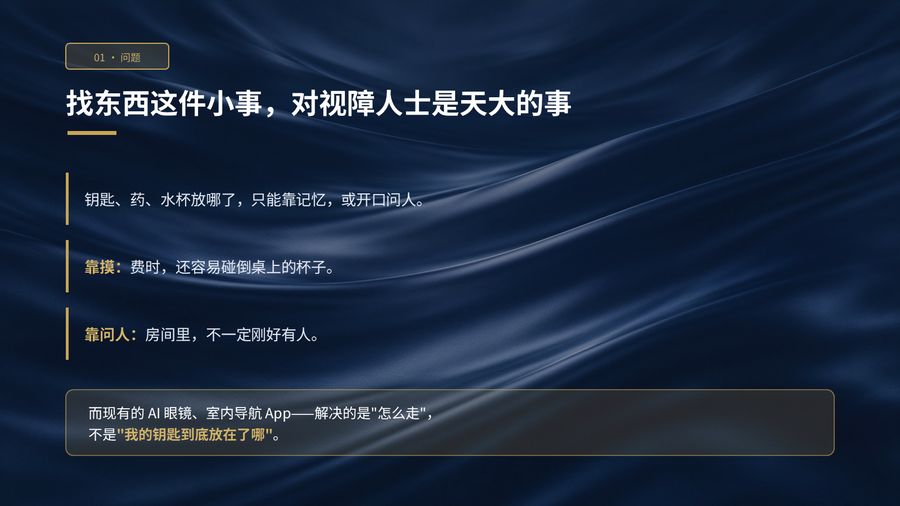
01 · 问题
找东西这件小事,对视障人士是天大的事
钥匙、药、水杯放哪了,只能靠记忆,或开口问人。
靠摸
费时,还容易碰倒桌上的杯子。
靠问人
房间里,不一定刚好有人。
而现有的 AI 眼镜、室内导航 App
解决的是「怎么走」,不是「我的钥匙到底放在了哪」。
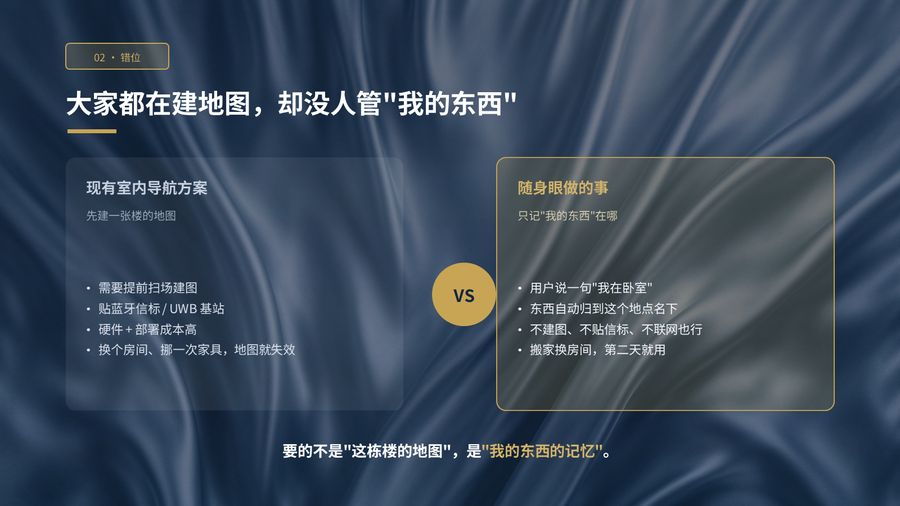
02 · 错位
大家都在建地图,却没人管「我的东西」
现有室内导航方案
- 先建一张楼的地图
- 需要提前扫场建图
- 贴蓝牙信标 / UWB 基站
- 硬件 + 部署成本高
- 换个房间、挪一次家具,地图就失效
随身眼做的事
- 只记「我的东西」在哪
- 用户说一句「我在卧室」,东西自动归到这个地点名下
- 不建图、不贴信标、不联网也行
- 搬家换房间,第二天就用
要的不是「这栋楼的地图」,是「我的东西的记忆」。
03 · 核心创意 · 最重要
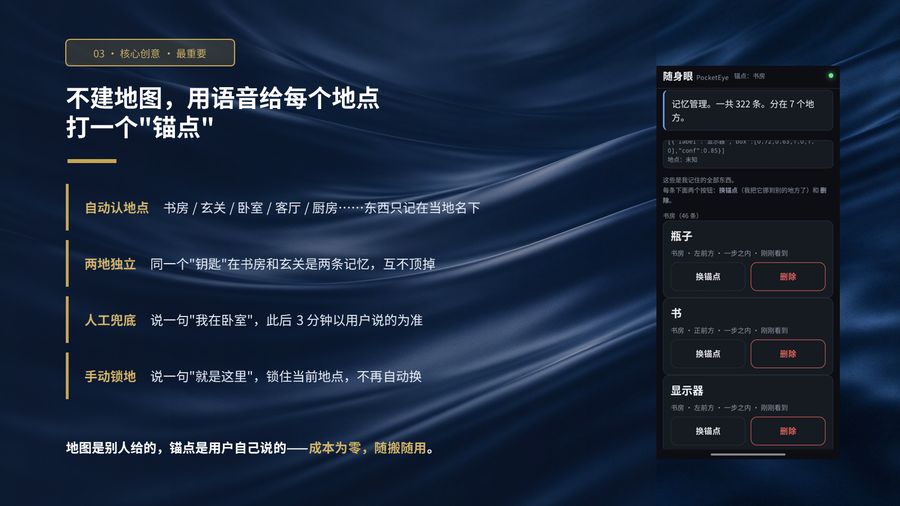
不建地图,用语音给每个地点打一个「锚点」
- 自动认地点书房 / 玄关 / 卧室 / 客厅 / 厨房……东西只记在当地名下
- 两地独立同一个「钥匙」在书房和玄关是两条记忆,互不顶掉
- 人工兜底说一句「我在卧室」,此后 3 分钟以用户说的为准
- 手动锁地说一句「就是这里」,锁住当前地点,不再自动换
地图是别人给的,锚点是用户自己说的——成本为零,随搬随用。
04 · 用户怎么用
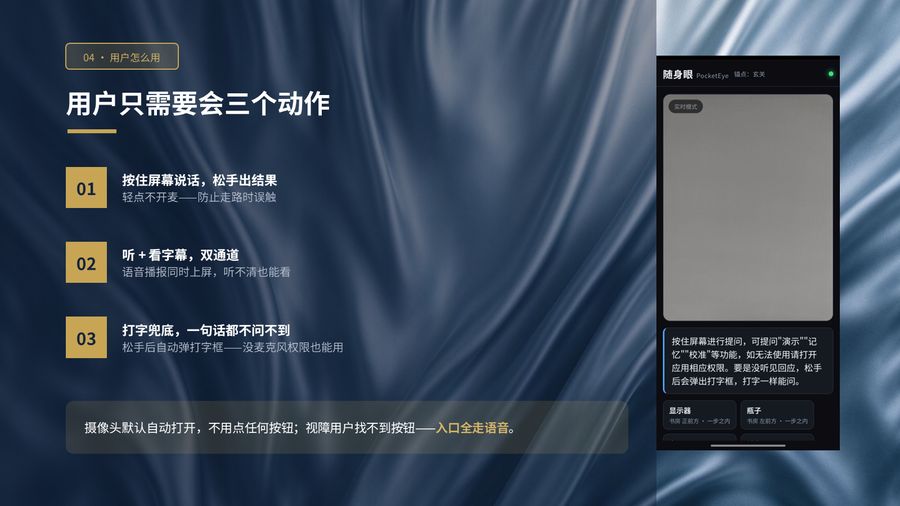
用户只需要会三个动作
按住屏幕说话,松手出结果
轻点不开麦——防止走路时误触
听 + 看字幕,双通道
语音播报同时上屏,听不清也能看
打字兜底
松手后自动弹打字框——没麦克风权限也能用
摄像头默认自动打开,不用点任何按钮;视障用户找不到按钮——入口全走语音。
05 · 语音即界面
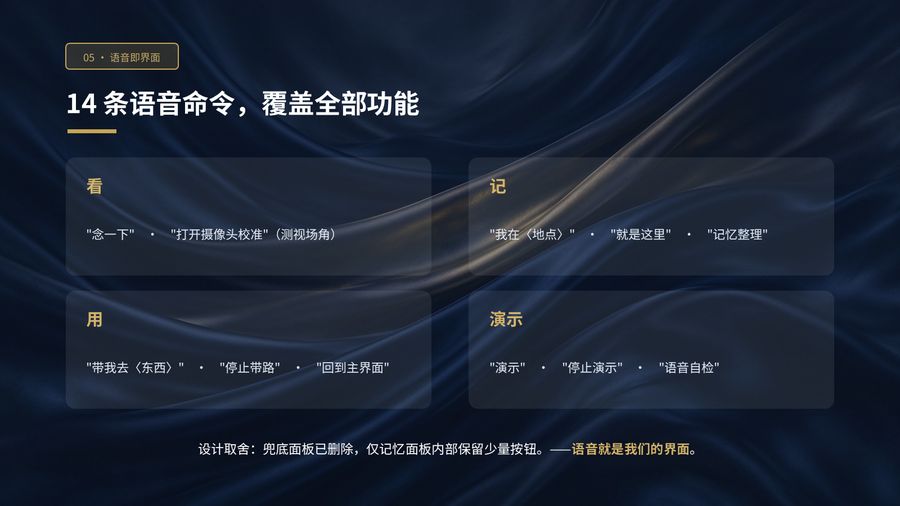
14 条语音命令,覆盖全部功能
看
「念一下」·「打开摄像头校准」(测视场角)
记
「我在〈地点〉」·「就是这里」·「记忆整理」
用
「带我去〈东西〉」·「停止带路」·「回到主界面」
演示
「演示」·「停止演示」·「语音自检」
- 念一下
- 演示
- 停止演示
- 记忆
- 整理
- 校准
- 带我去 ×
- 停止带路
- 回到主界面
- 打开摄像头
- 语音自检
- 我在 ×
- 就是这里
- 记住了
设计取舍:兜底面板已删除,仅记忆面板内部保留少量按钮。——语音就是我们的界面。
06 · 不编造
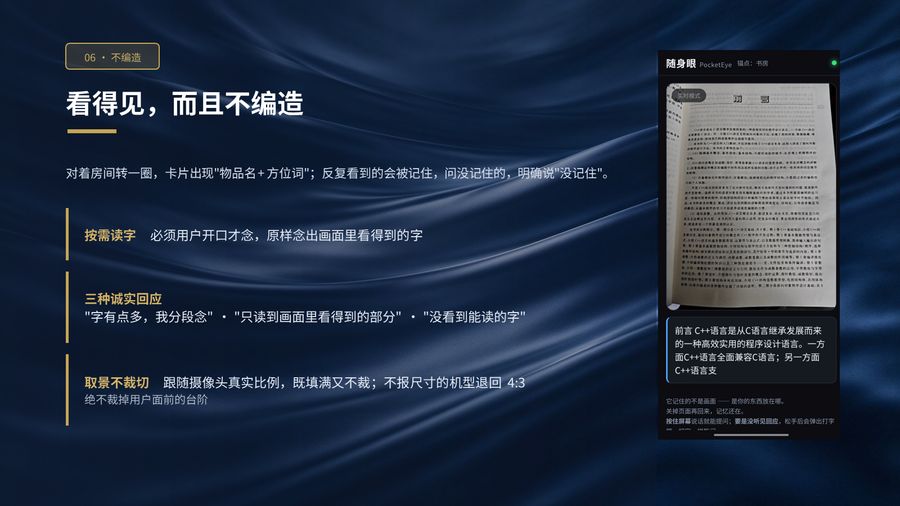
看得见,而且不编造
对着房间转一圈,卡片出现「物品名 + 方位词」;反复看到的会被记住,问没记住的,明确说「没记住」。
按需读字
必须用户开口才念,原样念出画面里看得到的字
三种诚实回应
「字有点多,我分段念」·「只读到画面里看得到的部分」·「没看到能读的字」
取景不裁切
跟随摄像头真实比例,既填满又不裁;不报尺寸的机型退回 4:3
绝不裁掉用户面前的台阶。
07 · 深水区设计
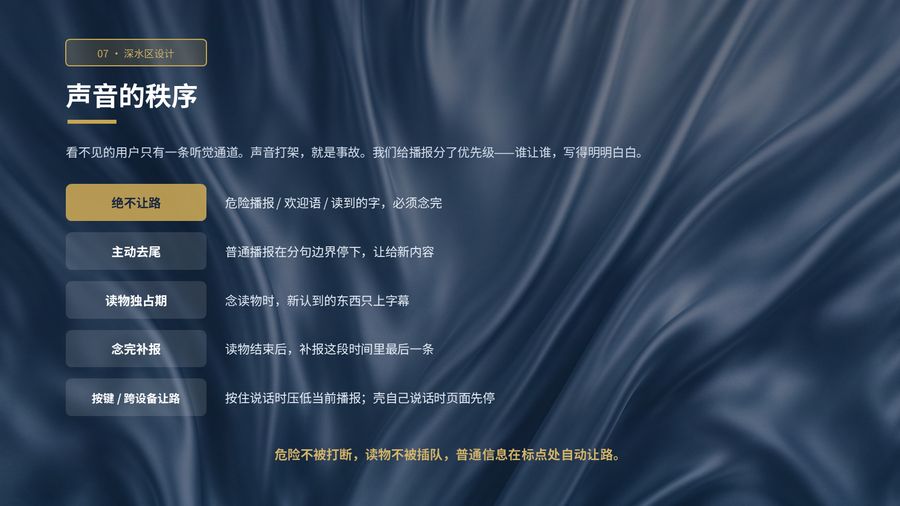
声音的秩序
看不见的用户只有一条听觉通道。声音打架,就是事故。我们给播报分了优先级——谁让谁,写得明明白白。
- 绝不让路危险播报 / 欢迎语 / 读到的字,必须念完
- 主动去尾普通播报在分句边界停下,让给新内容
- 读物独占期念读物时,新认到的东西只上字幕
- 念完补报读物结束后,补报这段时间里最后一条
- 按键 / 跨设备让路按住说话时压低当前播报;壳自己说话时页面先停
危险不被打断,读物不被插队,普通信息在标点处自动让路。
08 · 从看到到走到
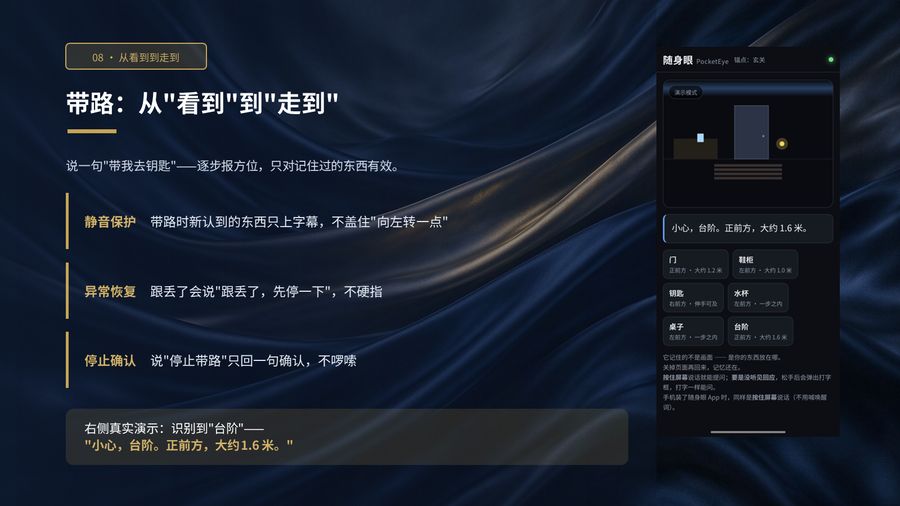
带路:从「看到」到「走到」
说一句「带我去钥匙」——逐步报方位,只对记住过的东西有效。
- 静音保护带路时新认到的东西只上字幕,不盖住「向左转一点」
- 异常恢复跟丢了会说「跟丢了,先停一下」,不硬指
- 停止确认说「停止带路」只回一句确认,不啰嗦
真实演示:识别到「台阶」——「小心,台阶。正前方,大约 1.6 米。」
09 · 现场演示
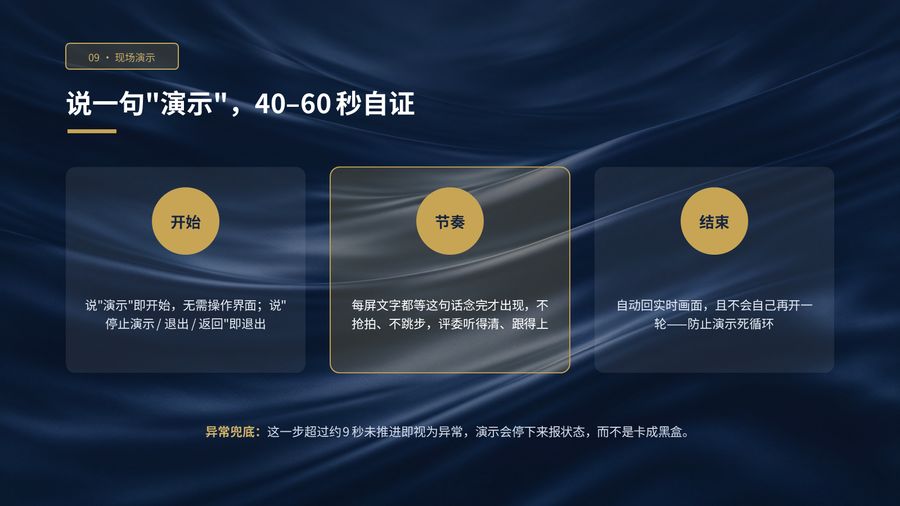
说一句「演示」,40–60 秒自证
开始
说「演示」即开始,无需操作界面;说「停止演示 / 退出 / 返回」即退出
节奏
每屏文字都等这句话念完才出现,不抢拍、不跳步,评委听得清、跟得上
结束
自动回实时画面,且不会自己再开一轮——防止演示死循环
异常兜底:这一步超过约 9 秒未推进即视为异常,演示会停下来报状态,而不是卡成黑盒。
10 · 诚实边界
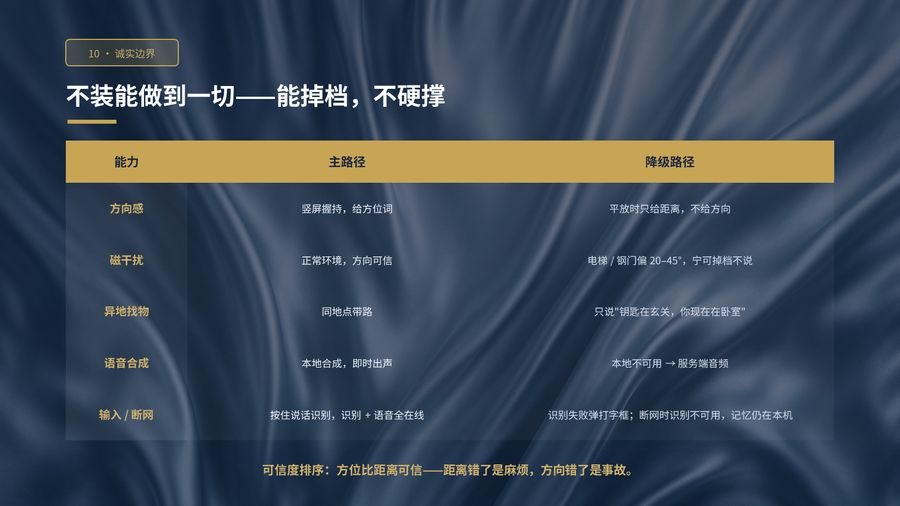
不装能做到一切——能掉档,不硬撑
可信度排序:方位比距离可信——距离错了是麻烦,方向错了是事故。
危险物播报 · 未验
真机尚未触发过——「没遇到」不等于「通过」。
网页端指南针精度
只能按中等精度上报;安卓壳侧朝向更完整。
11 · 工程细节
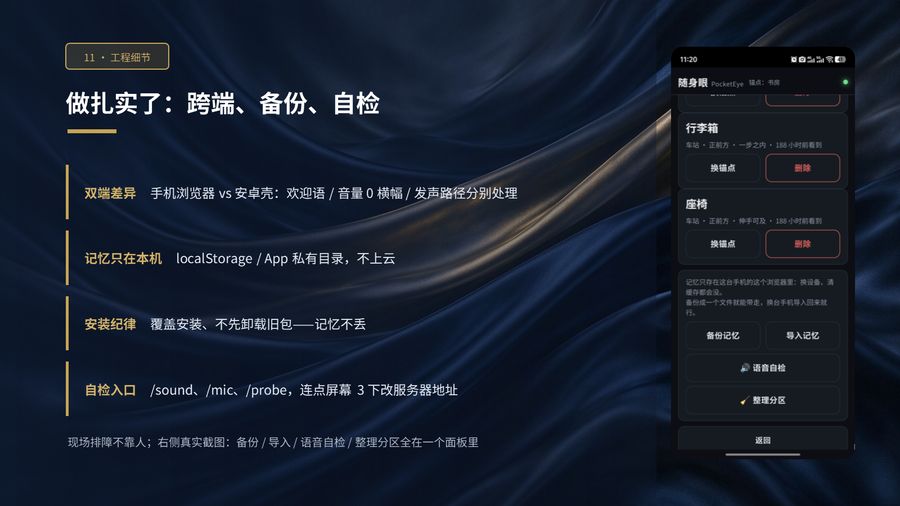
做扎实了:跨端、备份、自检
- 双端差异手机浏览器 vs 安卓壳:欢迎语 / 音量 0 横幅 / 发声路径分别处理
- 记忆只在本机localStorage / App 私有目录,不上云
- 安装纪律覆盖安装、不先卸载旧包——记忆不丢
- 自检入口/sound、/mic、/probe,连点屏幕 3 下改服务器地址
现场排障不靠人;备份 / 导入 / 语音自检 / 整理分区全在一个面板里。
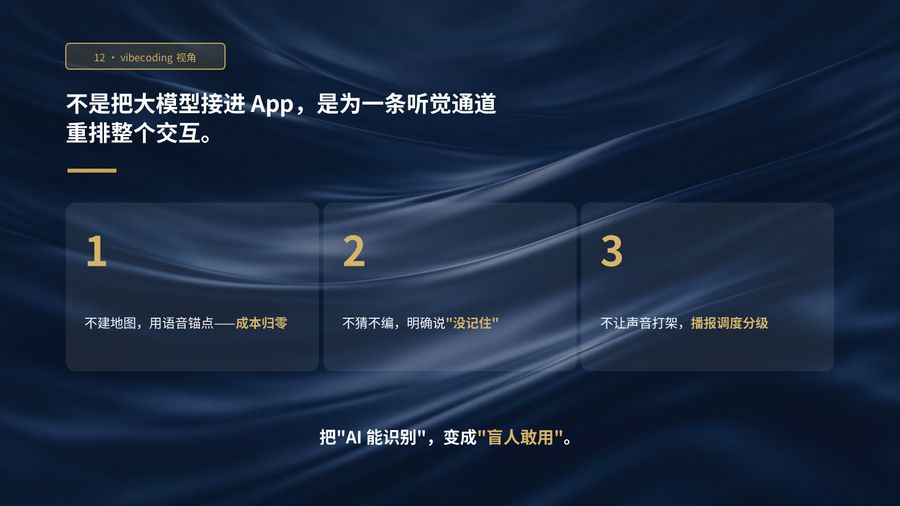
12 · vibecoding 视角
不是把大模型接进 App,是为一条听觉通道重排整个交互
不建地图,用语音锚点
成本归零
不猜不编
明确说「没记住」
不让声音打架
播报调度分级
把「AI 能识别」,变成「盲人敢用」。
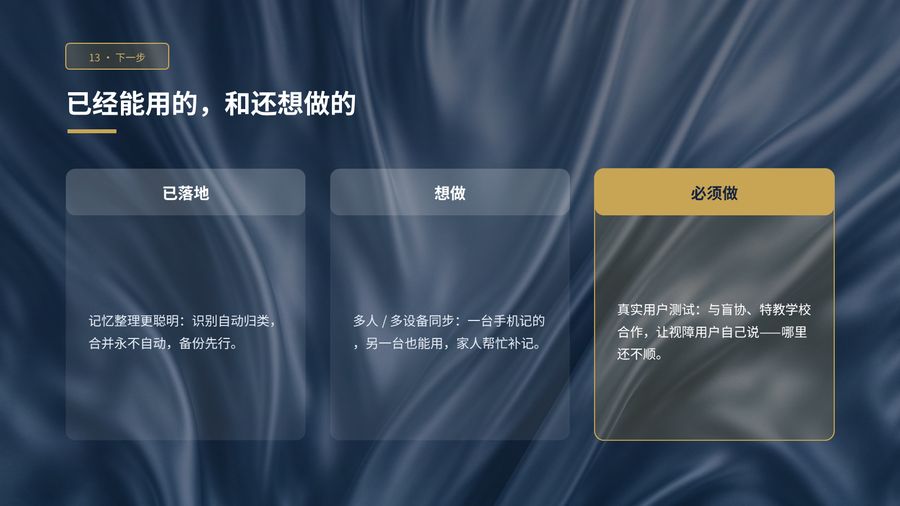
13 · 下一步
已经能用的,和还想做的
已落地
记忆整理更聪明:识别自动归类,合并永不自动,备份先行。
想做
多人 / 多设备同步:一台手机记的,另一台也能用,家人帮忙补记。
必须做
真实用户测试:与盲协、特教学校合作,让视障用户自己说——哪里还不顺。
真机演示 · 6 张实机照片
按住说话,然后听。
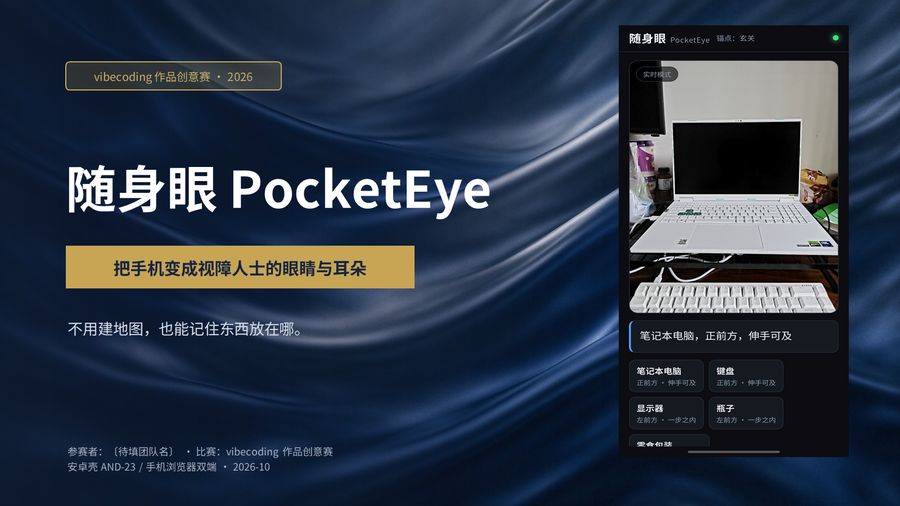
打开自动开摄像头,按住屏幕任意位置说话、松手听到回答;轻点不开麦,防误触。
← 左右滑动看 6 张实机照片 →
工程与验证
每一版上线前,全部全绿
vivo iQOO 15 · OriginOS 6 · 壳 AND-2.8
上线纪律:改动先备份留回滚点 · 四方哈希一致 · 匿名 403 / 带口令 200 / 健康检查 200 · 日志零 ERROR。
完整介绍 · 答辩版
16 页,原样放上来
左右滑动逐页看;点击任意一页放大。
← 左右滑动 →
联系方式 / 二维码:待定。
参赛团队
WXN
成员(按字母序)与职责
vibecoding 作品创意赛 · 2026-10